KeepFlash Daily

2026年9月28日 · 第 9 期

斯坦福 CS329A 课程封面

YouTube 系列9 集10h 40m

Stanford Online

斯坦福 CS329A《自我改进 AI 智能体》全九讲

CS329A Self-Improving AI Agents

核心要点(3条)
  • 「生成-验证差距」是贯穿全课的主线:采样很便宜,验证才稀缺。
  • 自我改进闭环离不开过程监督、稳健的验证器和对奖励破解的防御。
  • METR 的翻倍时钟与 GDPval 让智能体进步落在可度量的标尺上。

剧集

  1. 斯坦福 CS329A 第 1 讲课程视频封面

    01 · 1h 9m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 1 讲:课程总览

    第 1 讲为整门课程搭好框架:从缩放定律一路讲到智能体工作流。

    阅读
  2. 斯坦福 CS329A 第 2 讲课程视频封面

    02 · 1h 3m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 2 讲:测试时计算扩展

    第 2 讲量化测试时扩展,并提出「生成-验证差距」这一核心概念。

    阅读
  3. 斯坦福 CS329A 第 3 讲课程视频封面

    03 · 1h 12m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 3 讲:稳健验证

    第 3 讲深入验证器:过程监督与结果监督、信用分配与奖励破解。

    阅读
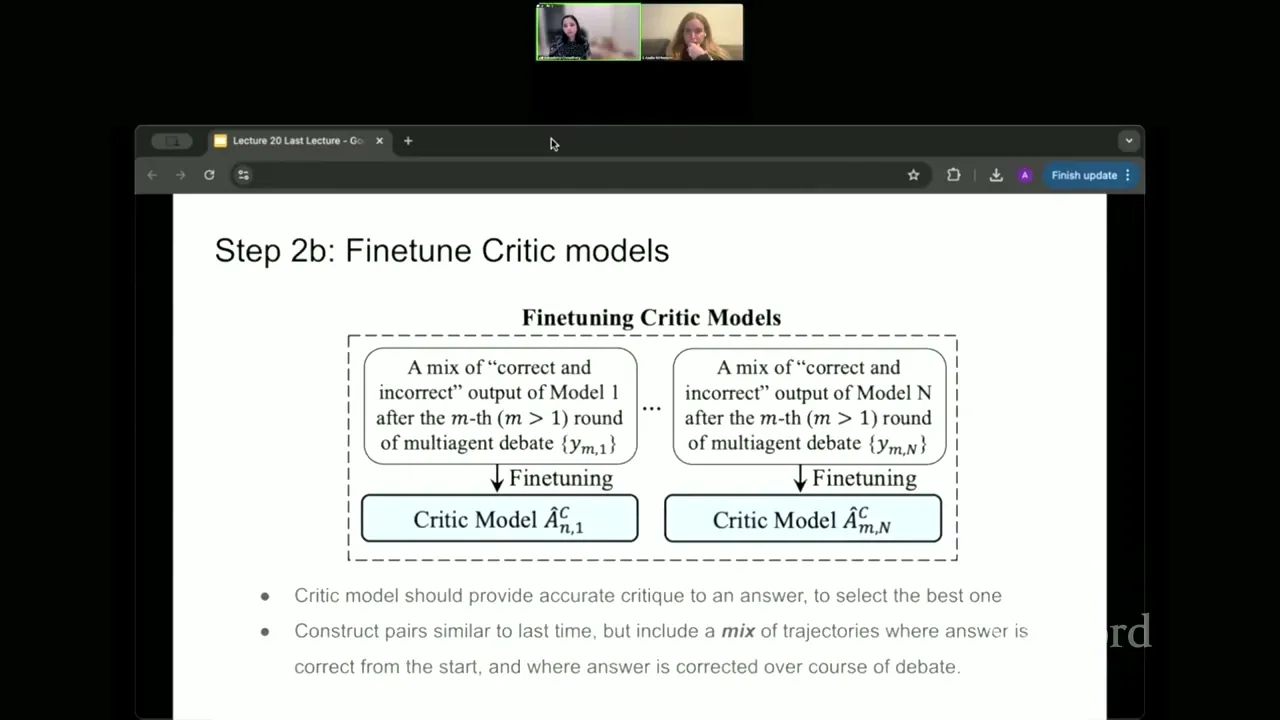
  4. 斯坦福 CS329A 第 4 讲课程视频封面

    04 · 1h 11m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 4 讲:从工具与代码反馈中学习

    第 4 讲展示智能体如何从工具动作、单元测试与 AI 批评中学习。

    阅读
  5. 斯坦福 CS329A 第 5 讲课程视频封面

    05 · 1h 14m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 5 讲:规划与多步推理

    第 5 讲为智能体加入规划能力:树搜索、并行计划与合成轨迹训练。

    阅读
  6. 斯坦福 CS329A 第 6 讲课程视频封面

    06 · 1h 12m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 6 讲:训练时扩展与 RL 扩展

    第 6 讲把扩展搬进训练:STaR、GRPO 与 DAPO 在 AIME 上接力。

    阅读
  7. 斯坦福 CS329A 第 7 讲课程视频封面

    07 · 1h 12m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 7 讲:自我改进与深度研究智能体

    第 7 讲放大自我改进:AlphaCode 的采样预算与 Search-O1 的研究环。

    阅读
  8. 斯坦福 CS329A 第 8 讲课程视频封面

    08 · 1h 15m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 8 讲:智能体评测与长程任务

    第 8 讲诚实地测量智能体:任务时程、GDPval 与典型失败模式。

    阅读
  9. 斯坦福 CS329A 第 9 讲课程视频封面

    09 · 1h 7m

    斯坦福 CS329A 自我改进 AI 智能体 · 第 9 讲:未来研究方向

    第 9 讲收在开放问题上:元验证、Absolute Zero 与每瓦智能体。

    阅读