
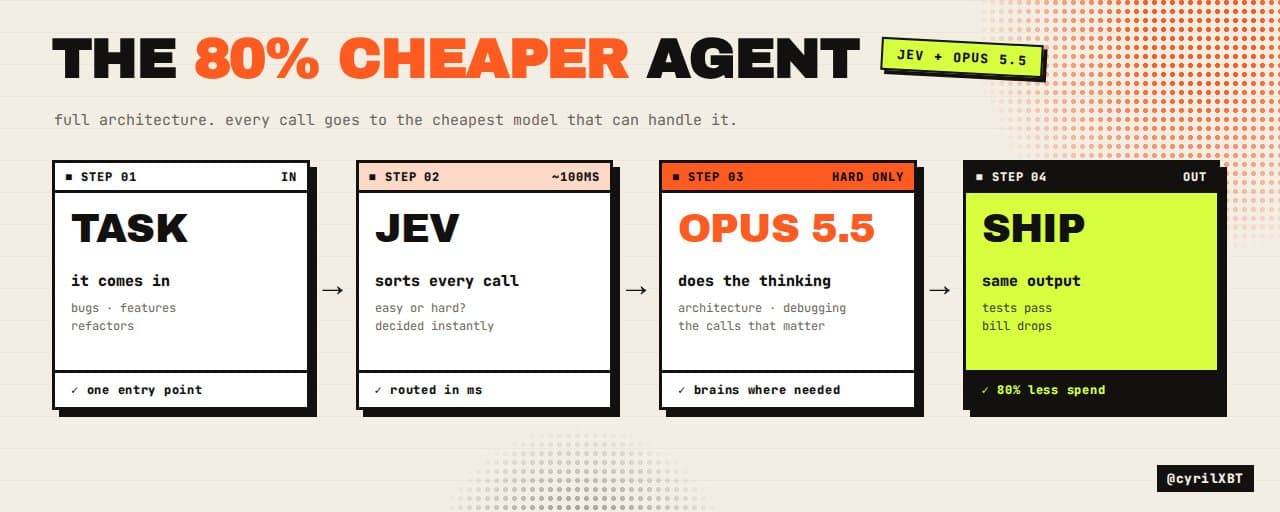
How to Build a Coding Agent That Costs 80% Less: Jev + Opus 5.5 (Full Architecture)
你的编码智能体正在为回答选择题支付旗舰模型的价格。
该加载哪些笔记?这一步该交给大模型还是小模型?工具刚刚失败了。重试、修复,还是放弃?哪些测试应该先跑?
每一个都是只有四五个候选答案的问题。而在今天大多数智能体架构里,每一个都由你手头最贵的模型来回答:开着思考模式,读完整份上下文,下结论之前还要先写上一大段。
这就是泄漏点。
本文教你如何堵上它。Opus 5.5 保留困难的推理:规划、写代码、调试。Jev 接管几乎每一步都会出现的那四个决策。你的 Harness 负责准备选项、校验答案,并做最终裁决。
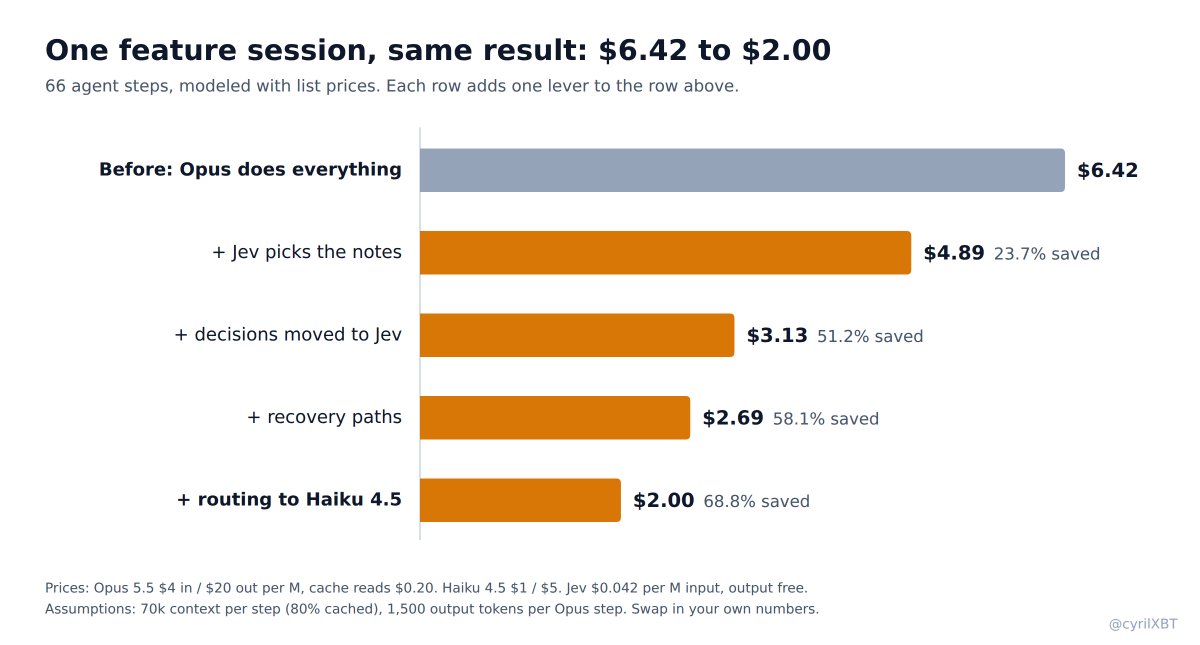
在下面的完整算例中,一次功能开发会话的成本从 $6.42 降到 $2.00。便宜了 69%,而且每一行算术都写在本文里,你可以套用自己的数字逐一核对。
本文写给所有在真实工作上运行编码智能体的人:用 Claude Code 的、在 API 上自建 Harness 的,以及介于两者之间的各种情况。你不需要重写你的智能体。文中的每个组件都能作为一个函数调用插进现有循环,并带一个随时可以关掉的开关。如果你读过我那篇 Jev + Claude Code 的文章,这一篇是它的升级版:同样的思路,更新的推理模型,以及四个具体决策,而不是一条泛泛的原则。
你需要一个 Jev API key、一个 Anthropic API key,以及大约一周的自家智能体日志作为对照基准。
开始动手。
问题所在:一个模型干着两份活
观察一个编码智能体工作十分钟,你就会看到它在做两种截然不同的工作。
第一种工作是推理。规划一个功能。编写一个函数。读堆栈跟踪,弄清为什么日期解析器一到闰年就出错。这类工作是开放式的,答案不在任何列表上。在这里你要用买得起的最聪明的模型,而 Opus 5.5 非常擅长此事。
第二种工作是做决策。从四十条项目笔记里挑出要紧的三条。判断一次重命名可以交给便宜模型。决定 npm test 超时之后该怎么办。挑选在全量跑 1,400 个测试文件之前先跑哪 12 个。这些答案都在列表上,列表很短,而且你的代码可以直接照着答案行动。
大多数智能体用同一个模型干这两份活,因为默认就是这么用的。循环调用 Opus,Opus 思考,Opus 作答,循环继续。
这样能跑通。但它又慢又贵,而且这种贵很容易被忽略,因为决策调用单次看起来并不贵。一次「我需要哪些笔记」的调用大概只要一美分。但它每一步都会发生,而且每次都拖着完整的上下文。
还有第二笔更容易被漏掉的成本:当智能体决定不了该加载什么时,它就全部加载。每条项目笔记、每份规范文档、每个历史决策,统统塞进每一次调用。Opus 5.5 已把缓存读取降到每百万 token $0.20 的低价,但「便宜 × 六十步 × 你的整个笔记文件夹」加起来依然可观。
解法:Opus 推理,Jev 决策,你的 Harness 立规矩
Jev 是 TypeSafe 推出的模型,专为第二种工作而生。它不写文本。你给它上下文和带固定选项集的类型化问题,它为每个选项交回一个概率。它以毫秒级速度作答,输入价格为每百万 token $0.042,输出免费。
于是整套架构一句话就能说清:
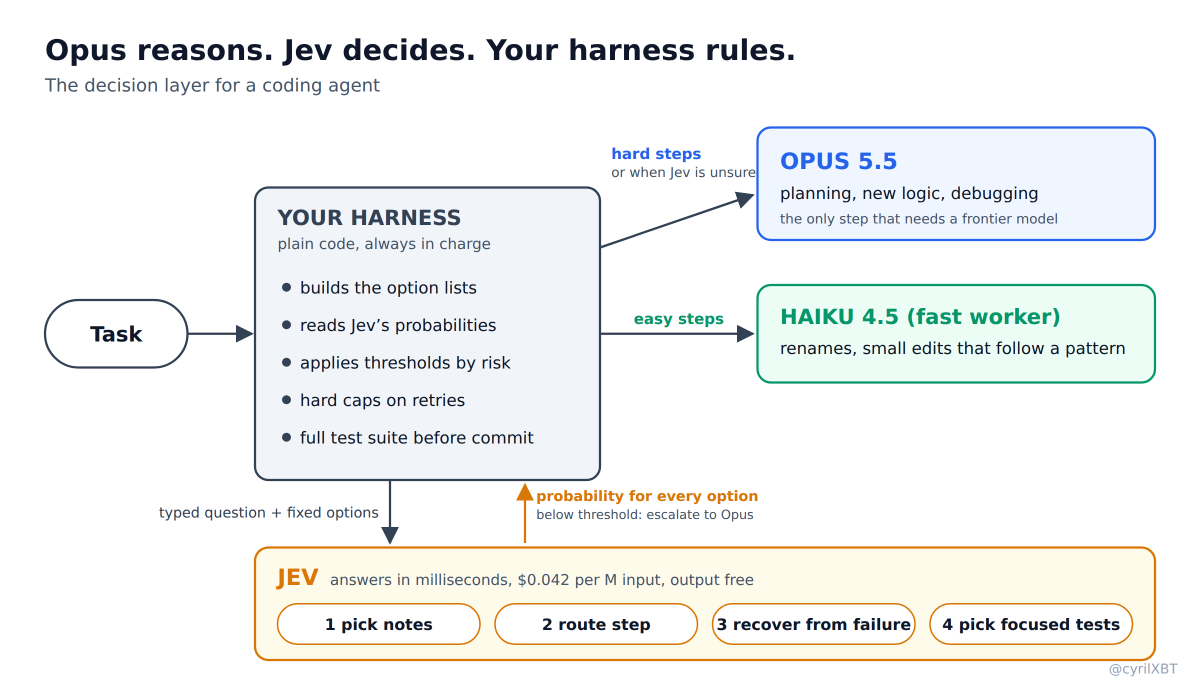
Opus 5.5 负责推理。规划、代码、调试,一切答案不在列表上的工作。
Jev 负责小决策。它从你的 Harness 准备好的选项中挑选。
你的 Harness 始终掌权。它构建选项列表、读取概率、应用阈值,并在 Jev 不确定时回退到 Opus。
第三条正是人们会跳过的那条,而它恰恰是让整套东西安全的关键。Jev 永远不会自己发明选项。Jev 永远不会对不可撤销的事情拥有最终决定权。「足够确定」是什么意思,由你的代码说了算。
下面这个辅助函数是本文其余一切的地基:
from dataclasses import dataclass @dataclass class Decision: answer: str prob: float probs: dict confident: bool def jev_choice(context: str, question: str, options: list[str]): # Wire this to your Jev client: the TypeSafe SDK, Vercel AI Gateway, # or the LangChain package. It must return {option: probability} # for every option you passed in. raise NotImplementedError def decide(context: str, question: str, options: list[str], threshold: float): probs = jev_choice(context, question, options) answer = max(probs, key=probs.get) return Decision(answer, probs[answer], probs, probs[answer] >= threshold)
注意里面没有什么:没有任何询问 Jev 有多自信的问题。你直接读它返回的概率。问任何模型「你确定吗?」几乎每次都会得到「确定」。概率才是诚实的信号。
接下来是那四个决策。
决策 1:加载上下文前先挑出相关项目笔记
这是单项最大的杠杆,也是几乎还没有人实现的一个。
你的智能体有一个笔记文件夹。一份 AGENTS.md、架构文档、编码规范、历史决策,还有「没有 migration 不许碰 billing 模块」之类的警告。加起来可能有 30,000 token。大多数智能体每次调用都全部加载,因为没人愿意成为漏掉重要笔记的那个人。
所以别再全部加载,而是就每条笔记并行地问 Jev 一个简单问题:智能体做这个任务需要这条笔记吗?
第一步,按标题把笔记切成块。AGENTS.md 的每一节自成一块。每份架构文档变成一块或多块。
import re def chunk_notes(markdown: str, source: str): parts = re.split(r"\n(?=## )", markdown) return [{"source": source, "text": p.strip()} for p in parts if p.strip()]
然后对照当前任务给每个分块打分:
from concurrent.futures import ThreadPoolExecutor def pick_notes(task: str, notes: list[dict], keep: int = 6, floor: float = 0.55): def score(note): probs = jev_choice( context=f"TASK:\n{task}\n\nNOTE ({note['source']}):\n{note['text']}", question="Would an engineer need this note to do the task correctly?", options=["needed", "not_needed"], ) return probs["needed"], note with ThreadPoolExecutor(max_workers=16) as pool: scored = sorted(pool.map(score, notes), key=lambda s: s[0], reverse=True) picked = [n for p, n in scored[:keep] if p >= floor] return picked or [n for _, n in scored[:2]]
这里的三个细节很关键。
不可协商的笔记始终加载。有些笔记无论如何都该出现在每次调用里:安全规则、「永不 force push」、注明哪个数据库是生产库的那一行。给这类笔记打上 always 标记,跳过评分。
保住下限和兜底。如果没有任何分块过 0.55 这条线,也仍然加载得分最高的两块。零上下文的智能体,比上下文略多的智能体更糟。
记录被丢弃的内容。当智能体犯错时,你要查的第一件事就是:那条本可避免错误的笔记是不是被筛掉了。这份日志就是你调优 keep 和 floor 的依据。
在完整算例中,仅这一项改动就把每次调用的笔记部分从 30,000 token 降到 6,000。单凭这一点,会话成本就能降约 24%。
决策 2:把合适的任务路由给更快的执行模型
不是每一步都需要 Opus。
跨八个文件重命名一个函数不需要。给一个已经有九个同款字段的表单再加一个字段不需要。更新一个 import 路径不需要。这些都是照着代码库里现成模式走的修改。
所以在每个步骤运行之前,由 Jev 给步骤分类,再由你的 Harness 把类别映射到执行模型:
ROUTES = { "rename_or_move": "fast", "small_edit_following_existing_pattern": "fast", "new_logic": "opus", "debugging": "opus", "design_decision": "opus", } def route(step: str, recent_diff: str): d = decide( context=f"STEP:\n{step}\n\nRECENT CHANGES:\n{recent_diff}", question="What kind of work is this step?", options=list(ROUTES), threshold=0.8, ) if not d.confident: return "opus" return ROUTES[d.answer]
看看这些选项是怎么写的。它们不是「简单」和「困难」,也绝对不是「小模型能搞定吗?」它们是你的代码能够映射成具体动作的工作类型。这就是每条 Jev 问题的规则:每个选项都必须是你的 Harness 知道如何执行的东西。
再注意默认值。低于 0.8,步骤交给 Opus。这里的路由错误只朝一个方向倾斜:难任务发给快速执行模型,代价是失败一步外加一次重试;简单任务发给 Opus,只是多花一点钱。所以拿不准时,往上交。
快速执行模型我用的是 Haiku 4.5,输入每百万 token $1,输出每百万 $5。在完整算例中,36 个实际工作步骤里有 12 个交给它。
决策 3:工具失败时选择恢复路径
工具会不停地失败。测试超时。文件路径写错。包没安装。shell 命令撞上权限错误。linter 抱怨一件毫不相干的事。
大多数智能体用最昂贵的方式处理这种事:把整个错误丢回给大模型,让它思考该怎么办。有时候这是对的。但更多时候答案显而易见,而 Opus 要花 1,500 个 token 重新发现 ENOENT 的意思是文件不存在。
更糟的是,智能体会陷进循环。重试、失败、重试、失败,每一次都为完整的推理步骤买单。
所以你把失败交给 Jev,并给它一组固定的恢复路径:
from collections import deque def tail(text: str, n: int = 4000): return "".join(deque(text, maxlen=n)) # last n characters of the error def recover(tool: str, command: str, error: str, attempt: int): if attempt >= 3: return "stop_and_report" d = decide( context=f"TOOL: {tool}\nCOMMAND: {command}\nATTEMPT: {attempt}\nERROR:\n{tail(error)}", question="What is the best next move after this failure?", options=RECOVERY, threshold=0.8, ) return d.answer if d.confident else "escalate_to_opus"
RECOVERY = [
    "retry_unchanged",       # flaky network or timeout
    "retry_after_install",   # missing package or tool
    "fix_path_and_retry",    # wrong file path or cwd
    "switch_tool",           # this tool can't do it, another can
    "escalate_to_opus",      # needs real debugging
    "stop_and_report",       # needs a human
]
重试次数的硬上限写在代码里,而不是模型里。再便宜的模型,也不该被允许无限重试。
每条恢复路径都映射到 Harness 里的一个小函数。retry_after_install 用正则从错误里读出缺失的包并安装。fix_path_and_retry 检查哪些路径真实存在并建议最接近的匹配。只有 escalate_to_opus 花真金白银,而且只在这个失败真正需要思考时才触发。
在完整算例中,这一项从会话里剔除了 6 个浪费在重试上的步骤。
决策 4:跑完整测试套件前先做聚焦检查
这一项省下的更多是时间而不是钱,而时间正是让智能体显得快的东西。
每次改动之后,大多数智能体都会跑完整测试套件。如果你的套件要跑四分钟,你的智能体每次编辑后都要干等四分钟,然后通读几百行输出,去找那一个真正要紧的失败。
修法与笔记如出一辙:拿 diff 给每个测试文件打分,先跑最相关的那些,只有聚焦检查通过后才跑完整套件。
def pick_tests(diff: str, test_files: list[str], keep: int = 12):
    def score(path):
        probs = jev_choice(
            context=f"DIFF:\n{diff[:12000]}\n\nTEST FILE: {path}",
            question="Could this change break tests in this file?",
            options=["likely", "unlikely"],
        )
        return probs["likely"], path

    with ThreadPoolExecutor(max_workers=16) as pool:
        scored = sorted(pool.map(score, test_files), key=lambda s: s[0], reverse=True)
    return [p for _, p in scored[:keep]]

def check(diff: str, test_files: list[str]):
    focused = pick_tests(diff, test_files)
    if not run_tests(focused):
        return False            # fail fast, fix before anything else
    return run_tests(test_files)  # full suite still gates the commit
把最后一行读两遍。任何东西提交之前,完整套件照常运行。聚焦检查是预警,不是替代品。大多数破坏你几秒内就能发现,而不是几分钟,而且完整套件本可拦住的东西,绝不会被你发出去。
再把廉价的检查排在最前面:只对改动的文件做类型检查和 lint。它们一秒搞定,却能在任何测试运行之前拦下多得惊人的错误。
组装成型:Harness 循环
四个决策在循环的单独一步里是这样安放的:
def run_step(task: str, step: str, state): # 1. context: load only the notes this step needs notes = state.always_notes + pick_notes(step, state.notes) # 2. routing: pick the worker for this step worker = state.workers[route(step, state.recent_diff())] result = worker.run(step, notes=notes, history=state.history) # 3. recovery: handle any tool failures in this step for failure in result.failures: action = recover(failure.tool, failure.command, failure.error, failure.attempt) state.apply_recovery(action, failure) # 4. checks: focused tests first, full suite before commit if result.diff: state.log_check(check(result.diff, state.test_files))
Opus 这边呢:就是你平常的 Opus 5.5 调用。把稳定上下文放在最前(系统提示词、工具定义、那些 always 笔记),让它在各步之间保持缓存,把步骤相关的内容放在最后。
import os import anthropic client = anthropic.Anthropic() OPUS = os.environ["OPUS_MODEL"] # your Opus 5.5 model id def opus_step(system: str, notes: list[dict], history: list, step: str): notes_text = "\n\n".join(n["text"] for n in notes) return client.messages.create( model=OPUS, max_tokens=8000, system=[{"type": "text", "text": system, "cache_control": {"type": "ephemeral"}}], messages=history + [{"role": "user", "content": f"NOTES:\n{notes_text}\n\nSTEP:\n{step}"}], )
没有任何玄乎的东西。省下的钱来自你不再发给它的内容,而不是某个精巧的提示词。
单步追踪
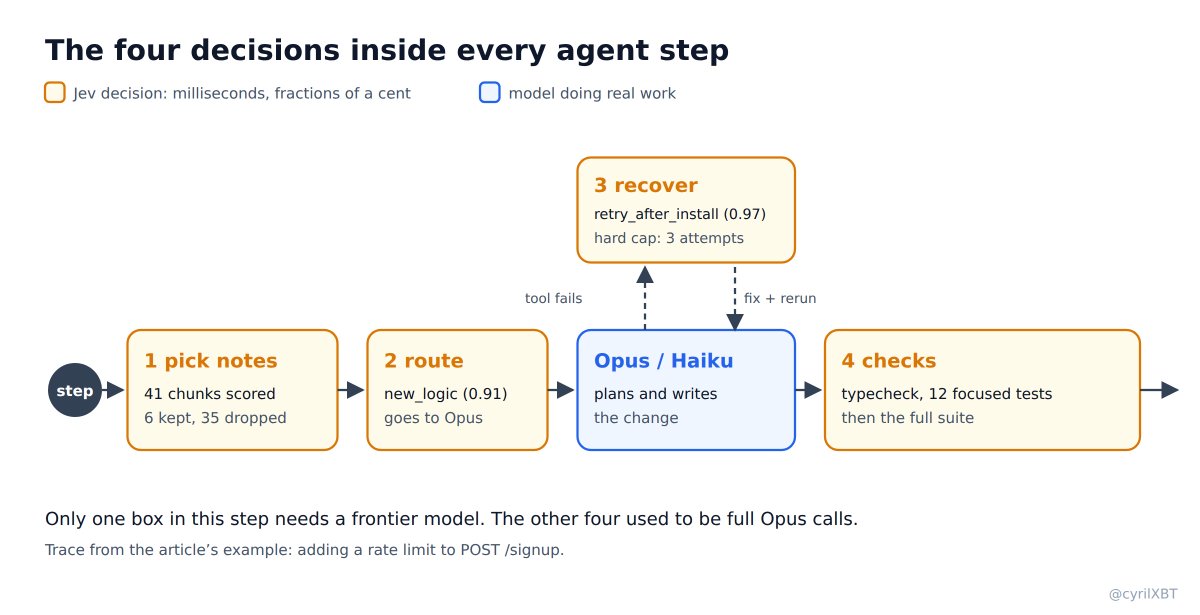
四个决策全部上线之后,日志里的一个步骤是这样的。任务:给公开注册端点加上限流。这条轨迹是示意性的,但它的形状和你在自己日志里看到的会一样。
step 14 "给 POST /signup 加上按 IP 的限流" [notes] 并行评分 41 个分块 保留: api/middleware.md (0.94), conventions/errors.md (0.88), infra/redis.md (0.81), decisions/2025_auth.md (0.62) 丢弃: 37 个分块, 包括计费、邮件模板、CI [route] new_logic (0.91) → opus [opus] 规划改动, 编写 middleware + config + handler 修改 [tool] npm test FAILED "Cannot find module 'bottleneck'" [recover] retry_after_install (0.97) → npm install, 重跑 [checks] 改动文件 typecheck: 通过 聚焦测试 (1,388 中的 12 个): 通过 完整套件: 通过
从上到下读一遍,数数其中几行过去本是一次完整的 Opus 调用。挑笔记:要么一次大调用,要么干脆不挑、盲目加载 30,000 token 的笔记。路由:没有这回事,每一步都交给 Opus。缺失的包:要花一整个推理步骤才能想明白「模块缺失」意味着「把模块装上」。挑测试:没有这回事,每次编辑都跑全量。
现在这条轨迹里只有一行是 Opus,而且是真正需要旗舰模型的那一行:规划并编写限流器。
整套思路就是这一幅图。昂贵的模型把时间花在只有它能做的那部分工作上。
完整算例:69% 从哪里来
下面是一次功能会话的完整算术:60 个智能体步骤,外加典型智能体一路上会攒下的 6 次浪费重试。所有价格均为当前公开标价。
改造前:Opus 5.5 包办一切
每一步加载 70,000 token 的上下文:15,000 给系统提示词和工具,30,000 给完整笔记文件夹,25,000 给到目前为止的对话。我假设其中 80% 是缓存命中。每步产出约 1,500 个输出 token,因为 Opus 5.5 的思考模式常开。
缓存读取: 56,000 × $0.20/M = $0.0112 非缓存输入: 14,000 × $4.00/M = $0.0560 输出: 1,500 × $20.00/M = $0.0300 每步 = $0.0972 66 步 × $0.0972 = $6.42
改造后:决策层
每步上下文降到 46,000 token,因为 Jev 挑出 6,000 token 的笔记,而不是加载全部 30,000。24 个纯决策步骤移交给 Jev。6 个重试循环消失。剩下 36 个工作步骤里有 12 个交给 Haiku 4.5。
Opus 5.5: 24 步 × $0.0742 = $1.78 Haiku 4.5: 12 步 × $0.0169 = $0.20 Jev: 102 次调用 × 5,000 tokens × $0.042/M, 输出免费 = $0.02 合计 = $2.00
从 $6.42 到 $2.00。同一个功能,便宜了 68.8%。
下面按叠加顺序看每个杠杆各贡献了多少:
仅笔记筛选 $4.89 节省 23.7% + 决策移交给 Jev $3.13 节省 51.2% + 恢复路径 $2.69 节省 58.1% + 路由到快速执行模型 $2.00 节省 68.8%
关于这笔账,有两句实话要说。
第一,这些是基于明确假设的推算数字,不是对你技术栈的实测。你的上下文大小、缓存命中率和决策数量都会不一样。把每一行都摆出来的意义,就是让你能换上自己的数字。等你量出了自己真实的改造前后,用你的数字,别用我的。
第二,看看钱实际花在哪儿。Jev 的 102 次调用总共只花两美分。省钱不是靠 Jev 单次调用便宜,而是靠 Jev 接管决策之后一切不再发生的事:臃肿的上下文、为选择题支付的完整推理步骤、重试循环,以及把重命名任务也丢给大模型。
为什么不干脆用 Haiku 来做这些决策?
问得在理。Haiku 4.5 又便宜又快。那为什么还要多引入一个模型?
三个理由。
它仍然在写文本。Haiku 用文本回答。你得在提示词里要求它从你的选项里选一个,然后解析答案,还得应付它偶尔附加解释、选了列表外的东西、或把答案裹进一整句话里的情况。Jev 则为你传入的每个选项返回一个概率。没有东西要解析,也没有列表外的答案。
你拿到的是完整分布,不只是一个答案。当 Jev 给出 needed: 0.52、not_needed: 0.48 时,你知道这是抛硬币,你的 Harness 可以上抛。当文本模型说出「needed」时,你根本不知道它有没有把握。只有看得见概率,阈值才成立。
成本算术也不同。Jev 输出免费,输入为每百万 token $0.042。每步给 41 个笔记分块打分,意味着每步 41 次小调用。用 Jev,这是不到一美分的零头。用任何文本模型,再便宜也是 41 次生成,各有各的输出成本和延迟。
小修改交给 Haiku——那才是它真正要写代码的场合。从列表里挑东西交给 Jev。思考交给 Opus。每个模型都做自己天生该做的活。
如何在不弄坏任何东西的前提下上线
别把四个决策一次全打开。下面是我会采用的顺序。
第 1 周:影子模式。你现有的智能体原样保留,一行不改。它每做一个决策,就把同一个问题也拿去问 Jev,并把两个答案连同 Jev 的概率一起记录下来。完全不要依据 Jev 的答案采取行动。
def shadow(decision_name, context, question, options, current_answer):
    probs = jev_choice(context, question, options)
    jev_answer = max(probs, key=probs.get)
    log_row(
        decision=decision_name,
        current=current_answer,
        jev=jev_answer,
        prob=probs[jev_answer],
        agree=(jev_answer == current_answer),
    )
第 2 周:读分歧。只看 Jev 和你现有智能体意见相左的那些行。按 Jev 的概率排序。你通常会看到一条干净的分界线:过了某个概率,Jev 的正确率和 Opus 不相上下。那条线就是你的阈值。这些分歧行还会变成你的测试集——从真实流量里免费造出来的测试集。
第 3 周:打开笔记筛选。它是最大的杠杆,也最容易回退,因为漏掉的笔记会很快在你的日志里现形。
第 4 周:打开恢复和测试。两者在代码里都有硬上限和兜底,所以最坏情况也不过是退回你今天的做法。
最后:路由。路由错误对用户来说最显眼,因为难任务发给快速执行模型就会产出糟糕的代码。把它放在最后开启,阈值取得保守些,并盯住快速执行模型步骤的失败率。
给每个决策都加一个开/关标志,让你能用一行代码撤销它。
按风险设定阈值
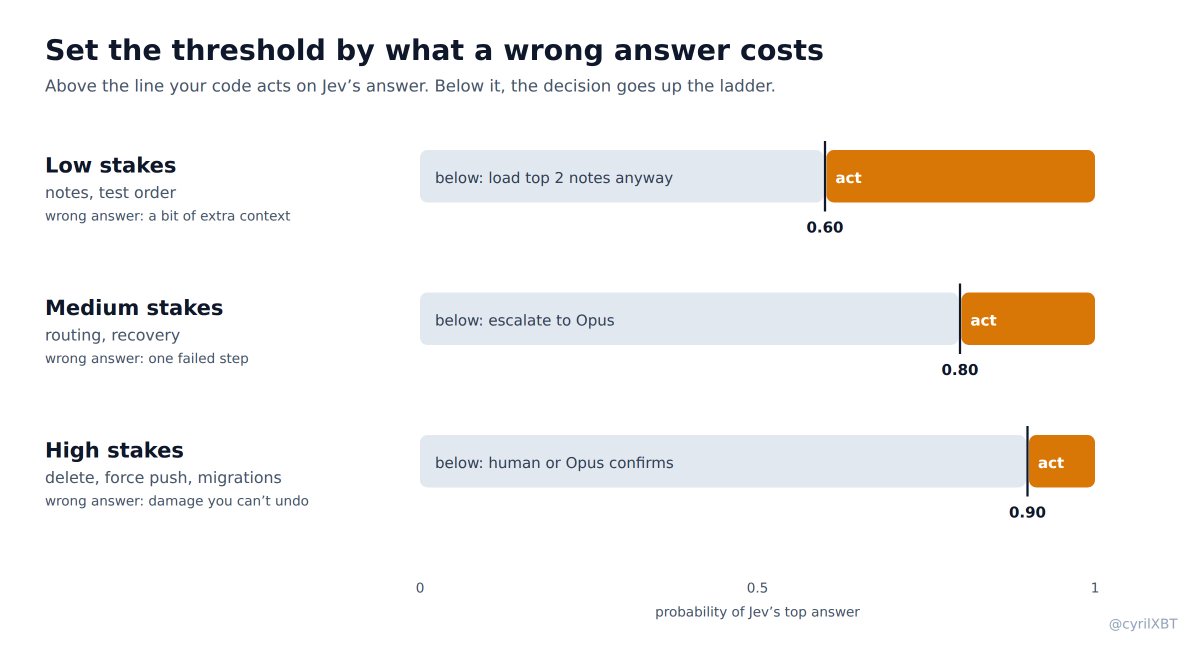
所有事情共用一个阈值是个错误。阈值要按答案出错时会发生什么来定。
低风险、易撤销:0.55 到 0.65。挑笔记。排测试顺序。答错的代价是一点上下文或几秒钟。
中风险:0.8。路由和恢复。答错的代价是失败一步,而你的 Harness 接得住。
高风险、难撤销:0.9,或者永远别做。删除文件。Force push。碰生产配置。跑 migration。我的坦率建议:别让任何模型单独做这些决定。把它们交给人类,至少也要交给带确认步骤的 Opus。
任何低于阈值的答案都沿阶梯上移:需要推理的交给 Opus,需要判断的交给人类。
这套方案帮不上忙的地方
这套架构不是对所有工作负载都生效的魔法倍增器。
纯生成型工作负载几乎没变化。如果你的智能体大部分时间在按清晰的规格大量编写新代码,就没有多少决策可以移走。笔记筛选的省钱仍然拿得到,但除此之外所剩不多。
微型项目用不上它。如果你的整个笔记文件夹只有 2,000 token、测试套件八秒跑完,搭建这套东西的开销暂时不值。
Jev 并不擅长独自做最终裁决。它擅长的是察觉事物和从短列表中挑选。「这个 pull request 可以合并了吗?」这种单一大问题不该交给它。把大问题拆成小问题,逐个打分,再在你自己的代码里用你自己的权重把结果组合起来。
如果某个固定问题你已经有标注数据,一个自己托管的小模型在价格上就能击败 Jev。Jev 的用武之地是问题不断变化、你又没有训练数据的场景——大多数编码智能体正是如此。
我会避开的错误
让模型自己写选项列表。整套架构依赖你的代码能够执行的选项。如果选项由模型生成,你就又回到了解析自由文本的老路。
问 Jev 它自不自信。要读的是概率。自我报告几乎总是「自信」。
没有兜底。每个 Jev 决策都需要一条「不确定」时的出路,那条路是 Opus 或人类,绝不是瞎猜。
把重试上限写进提示词而不是代码里。被叮嘱「只准重试 3 次」的模型偶尔会重试 30 次。代码不会。
砍掉完整测试套件。聚焦检查让你更快,完整套件让你不自欺。两个都要留。
什么都不测量。如果开工前不记录单次会话成本,你永远不会知道自己省了 20% 还是 70%。先拉出一周正常工作的用量。这只要十分钟,而且是唯一要紧的数字。
本周就能做的事
把整件事浓缩成一张清单:
1. 记录一周的智能体会话:步骤、token、成本、失败。 2. 找出藏在循环里的决策:笔记、路由、恢复、测试。 3. 把每一个写成带固定选项列表的问题。 4. 让 Jev 以影子模式在你现有智能体旁边跑一周。 5. 依据分歧日志、按风险设定阈值。 6. 先开启笔记筛选,再开恢复和测试,最后开路由。 7. 对比开启前后的单次会话成本。那就是你的数字。
Opus 5.5 是我用过最好的代码推理模型。错误在于让它把其他所有事也包办了。
让它思考。让 Jev 决策。让你的代码立规矩。
如果这篇文章对你有用,关注 @cyrilXBT。我每周拆解如何用最新的 AI 模型做构建,全部带真实数字。
收藏这篇,等你开始动手时就有得查了。