
I reverse-engineered Instinct's memory. Here's exactly how it works
过去两周,Instinct 席卷了整个圈子——它是我用过最好的 iMessage 助手之一。和对待每款产品一样,我决定逆向 Instinct 的记忆,搞清楚它到底怎么工作。
过去三年我一直在做 agent memory,也是 @supermemory 的创始人。这个行业一直在变,「agent memory 该怎么做」没有标准答案。每款产品都有不同的需求和约束!出乎意料的是,Instinct 的记忆和我们对 memory 的看法很契合,而且你完全可以用 supermemory 复现它(文末有 how-to)
因为做这件事太久了,我对记忆系统通常怎么工作有相当不错的直觉,所以我可以只从 agent 表面(iMessage 界面)探测,就能逆向出记忆系统。
这会有点长!
Instinct 由 Git 追踪的 Markdown 文件驱动。
本质上,记忆以 Git 追踪的 Markdown 文件存储,但为了让它无缝且快速,做了大量 harness 相关的工程。
回答模型(很可能是开源权重模型)会收到:
- 当前对话上下文
- 用户的身份「profile」
- 一份 memory one-pager(当前状况摘要)
- 一份 compaction recap
- 以及一份 to-do / Tasks 看板
Conversation messages ────────────────→ Current conversation context
        │                                         │
        └→ Background processing [unknown]         │
                      │                           │
             Accessible Markdown files            │
                 │              │                 │
       One-pager generation     Search / reads    │
       [mechanism unknown]      [on demand]       │
                 │              │                 │
                 └──────────────┴─────────────────┤
Identity profile + todo index + compaction recap ─┤
                                                  ↓
Agent's answer“我们通过大量提问探测、顺着一般假设推进,再逐一验证,才重构并收集到这些证据。这里大部分内容应该相当准确,但因为我没见过他们的代码,有些地方可能有误。”
除了这些文件,Instinct 还有大约 4,250 tokens 的某种「profile」,以及约 10k tokens 的压缩对话上下文(显然取决于具体对话)
那就从这里开始!

Profile 与 memory one-pager
Profile 本质上是模型_始终_需要知道的用户要点摘要。Instinct 的 profile 包含:
- Life context:对选定的用户处境及相关人物或工作的摘要。
- Autonomy calibration:关于助手何时应主动行动或提问的选定偏好。
- Channel communication style:关于如何沟通的选定偏好。
这些就是 Instinct 看到的「headers」。
“PS:Supermemory 内置了 profiles,https://supermemory.ai/docs/concepts/user-profiles,也有相同的经验总结;我们把 profile 拆成静态与动态两部分。”
这些 profile 是怎么形成的?
我能找到的、证据最充分的重构是:它是对已保存记录的派生摘要。我们不知道生成器读的是全部文件、变更文件、搜索结果、更早的摘要,还是独立存储的事实。生成器(或者说 dreaming、learning)的模型、prompt、调度、冲突处理,以及对 forget 请求的响应,至今未知。
在 agent 可访问的副本里没有找到完整的 one-pager 支撑文件;这并不能说明它实际存在哪里。所以,这个 profile 很可能不是一个文件,而只是某种临时创建的缓存。
这个 profile 也不是特别新。有时我能发现大约两天的 profile 滞后,但由于里面有日期,agent 能假定它并非完全可信。
“在 supermemory 里,profiles 会自动形成,并始终保持新鲜”
文件与文件夹
现在来看 Instinct 使用的文件结构。用了几天之后,它形成了这样的结构:

我发现很多冗余、过时或重复的信息,但那很可能只是为了帮助 agent 更好地找到答案。
“Instinct 报告称,commit 899f88a 把该偏好写入了 communications digest、daily timeline 和 dining note。README 描述了 raw、hourly 与 monthly 的 timeline 层级,但这些目录在可访问副本中并不存在。”
文件结构
据称文件使用结构化 headers,后接散文与要点列表。下面是一个示意例子:
---
id: dining
type: preference
aliases: [food, lunch, restaurants, takeout, delivery, dining]
---
- **Pasta:** Loves pasta; stated on 2026-09-15.
- Related context: [[related-record-id]]
从文件结构里,有几点很突出:
- 文件有名字,也有 IDs。
- 在我的账号里大约有 4 种类型:preference、person、organization 和 conversation
- 信息本身以事实列表的形式存在(尽管装在文件里)
- [[links]] 通过 ID 连接相关文件。
所以没错,这是一组稠密互联的文件,链接让它呈现出图结构。
还包含 aliases,后面 harness 相关部分会讲为什么。
创建、更新与整理信息
看起来 reconciliation commits 做的远不止追加信息:
- 把临时细节移入 workstreams。
- 缩短持久记录,同时链接到更完整的笔记。
- 把例子提炼成更宽泛的特质。
- 删除偶然细节。
- 用带日期的更正替换错误事实

版本管理
旧信息可以留在 Git history 里。即使当前事实文件已变更,它也可以留在带日期的笔记里。只有在模型明确去找旧版本时,这些信息才会被重新唤回。
“supermemory 的 ingestion 工作方式类似,而且由专门模型完成!另外,我们会自动纳入旧版本,模型不必自己去找。”
遗忘
Instinct 会根据 ingestion 运行时机等遗忘一些事。但目前这并不是「自动」的。
所以,一句明确的「这没有发生」_会被_忘掉,但「我这周末有考试」会留在记录里(除非模型看到它并选择删除)
“Supermemory 把遗忘性嵌入了系统。因此事物会自动遗忘与演化,而不需要 agent 亲自去做。”
Ingestion / 这些工作到底什么时候发生?
目前,ingestion 大约每 24 小时运行一次。(我是这么假设的,因为一条 preference 从消息到报告的 commit 大约花了 23 小时 16 分钟。)对了,如果你在 24 小时内给 Instinct 发太多消息,它会直接让你明天再来(因为超过某个 token 阈值就无法再 compact)
所以很可能是每天跑一次的 cron job,用来维护这组文件并编辑现有文件。
Harness——把记忆带到 agent
好,现在我们知道 Instinct 实际上如何放置和整理这些文件了。但 agent 到底怎么用这些信息?
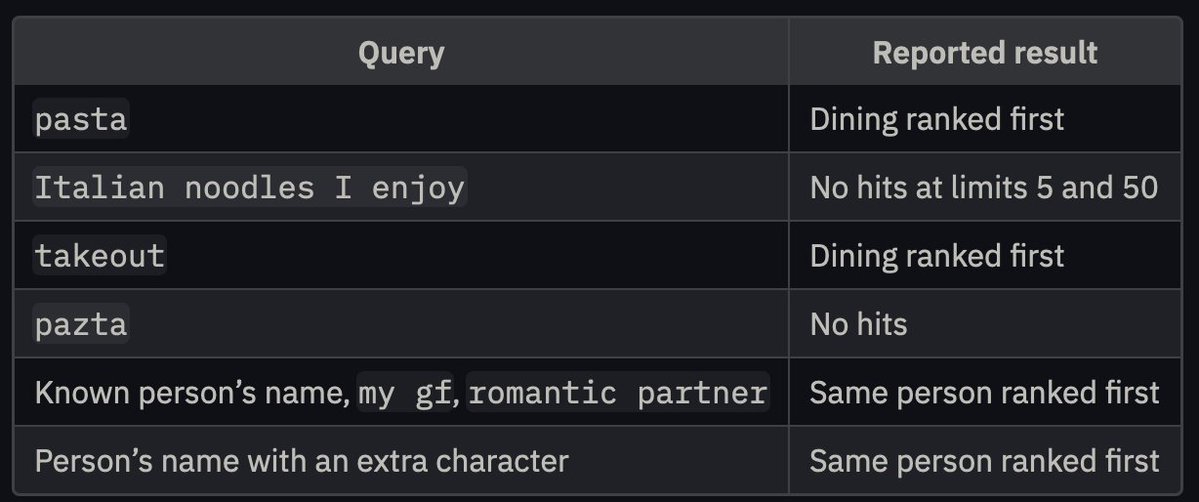
没有向量索引,也没有 BM25 搜索。
Instinct 几乎就是用关键词匹配 / grep 风格的查询在文件系统里查找。这就是为什么每个文件都带 aliases:这样当 agent 查找时,每个文件都更有机会被命中。
我是通过用多种方式跑多组不同查询发现的。
完整结构
Instinct 似乎在用类似 bash 的工具做 Grep、列出内容、检查 git,以及一些管理 TODO list 的工具。
- 对话开始时注入 profile
- Instinct 利用可用工具查找更多信息。profile 的一部分是可用内容的索引。
记忆是只读的,至少对 agent 而言是如此。
“这其实是我个人非常信奉的一点!合并信息的工作由后台进程完成,而不是主 agent。”
Instinct 记忆的表现
很难从 agent 表面做基准测试,但这是我对 Instinct 记忆的体感评分表:
- 单事实召回:✅
- 跨会话多跳:弱 ☑️
- 时间 / 近因:✅
- 更新与矛盾:✅
- 弃答(Abstention):✅
- 遗忘 / 衰减:部分——缺少自动遗忘;有剪枝
- 超过 1M tokens 或数月规模的表现:未测,但感觉不错 ☑️
- 程序性 / 技能记忆:❌ 不存在(我们能找到的记忆都不是方向性的)
- 测试时学习:✅ 对话内可纠正行为;持久化学习未验证
- 隐式个性化:❌(「给我买个显示器」→ 它应知道我是 founder、新办公室等,并建议高端选择)
- 显式个性化:✅
- 多模态:❌ 弱(「你知道我房间长什么样。我该买什么颜色的毯子?」)
- 写入侧成本:☑️ 可能很贵,但无法测试。 我们知道,随着 agent 为了 WRITE 更多信息(并做合并与管理)而必须 READ 现有信息,写入成本会指数级上升。对个人 agent 场景这应该还能接受,我们还不确定!
总体:在明确检索指令下很能打,自然个性化不稳定,遗忘保证仍未解决。
真的非常好!
用 supermemory 实现它
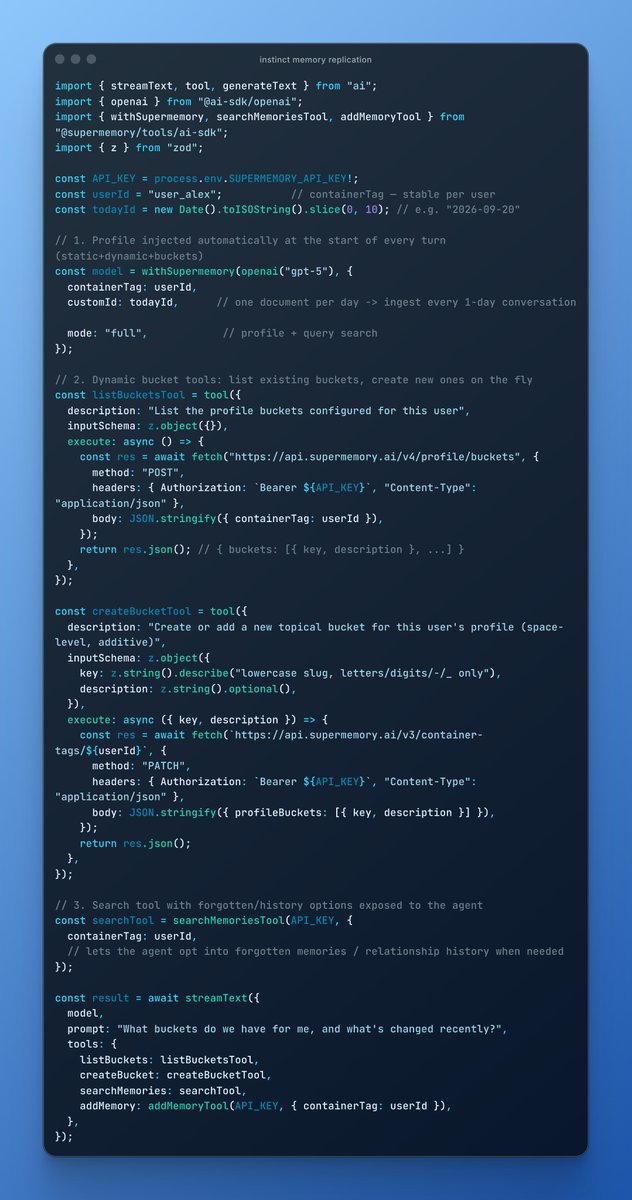
这里用 supermemory 有一些好处,而且实现起来其实超级直观!
- 实体与关系的 Buckets: Supermemory 支持 Profile Buckets。每个用户可以有自己的一组动态 buckets。这就像给 LLM 一个可访问的信息文件夹。https://supermemory.ai/docs/user-profiles/buckets
- 对话开始时的 Profile Supermemory 内置 profile 系统,因此会在开头注入
- 搜索工具 给 agent 搜索工具,并提供一些特定选项,比如纳入已遗忘内容和记忆历史——以防它需要这些! https://supermemory.ai/docs/api-reference/recall-search/search-memory-entries
- 每 1 天对话做一次 Ingest 类似 Instinct 的界面会在每轮调用 `memories.add()`,用当天作为 conversation 的 ID。 Supermemory 的 ingestion 会自动处理遗忘、调和与冲突解决。https://supermemory.ai/docs/concepts/graph-memory#dreaming-keeps-the-graph-alive Supermemory 也自动处理多模态 ingestion!
下面就是能跑通的完整 Instinct 记忆系统,在 supermemory 里~和 Instinct 一模一样。只要大约 60 行代码!!!!!
supermemory 专注于 memory(废话),因此运行更便宜、更快,同时又完全可组合。 我们不用 Git,而是有自己的、嵌入数据结构的版本系统。我们也不存完整文件,而是「按需」构造文件,这也确保信息始终新鲜。https://x.com/DhravyaShah/status/2101535378557874196?s=20
所以,这就是 Instinct 的记忆如何工作,以及如何用 supermemory 完整实现 Instinct 的记忆系统!