
Building Prod with Jev and LangGraph
上周,TypeSafe AI 发布了 Jev,一种全新的模型。与传统 LLM 不同,Jev 不生成文本,而是做出你的代码可以直接执行的决策,服务于 TypeSafe 所称的 AI 驱动软件——“代码掌管工作流,AI 只负责狭窄而结构化的决策”。TypeSafe 将其哲学总结为“造产品,不当神”。
随着前沿 LLM 越来越强,我们开始把它们当成神来用:凡是输入模糊的任务都找它——写文案、抽取文档、搜索、排序、调研、分类等等。遗憾的是,神既昂贵又缓慢。每一次调用你都在为这种通用性买单,哪怕你需要的只是一个“是”或“否”。
这也解释了 Jev 的发布为何引发如此多的关注。在狭窄的决策任务上——比如许多 agent 赖以构建的 routing 和分类步骤——TypeSafe 的基准测试显示,Jev 比主流 LLM 最快快 200 倍,成本最低可降至 1/400。
对 LangChain 的我们来说,TypeSafe 的思路甚至有几分亲切。我们的使命是让 agent 有用且无处不在,我们的开源生态也随着模型格局的演变而不断演进,但在每一步,我们都会回到同样两个问题:如何让模型做出有用的决策,以及如何可靠地对这些决策采取行动?
**LangGraph 正是我们对这两个问题的回答。它的构建源于我们帮助数千家公司把 AI 投入生产所积累的经验,它让你在可靠、可观测的系统中,把模型驱动的决策与确定性代码结合起来。Jev 则为这些系统提供了一种更快、更便宜的决策方式。在本文中,我们将介绍如何用 Jev 和 LangGraph“造产品,不当神”。
用 Jev 做决策
Jev 从前沿 LLM 的能力捆绑中单独取出“判断力”这一项,把它变成了一种便宜到无需计量的原语。它就是 TypeSafe 所称的 system one model——或者用更常见的说法:“决策模型”。你给它状态和一组问题,它返回带概率的类型化答案。
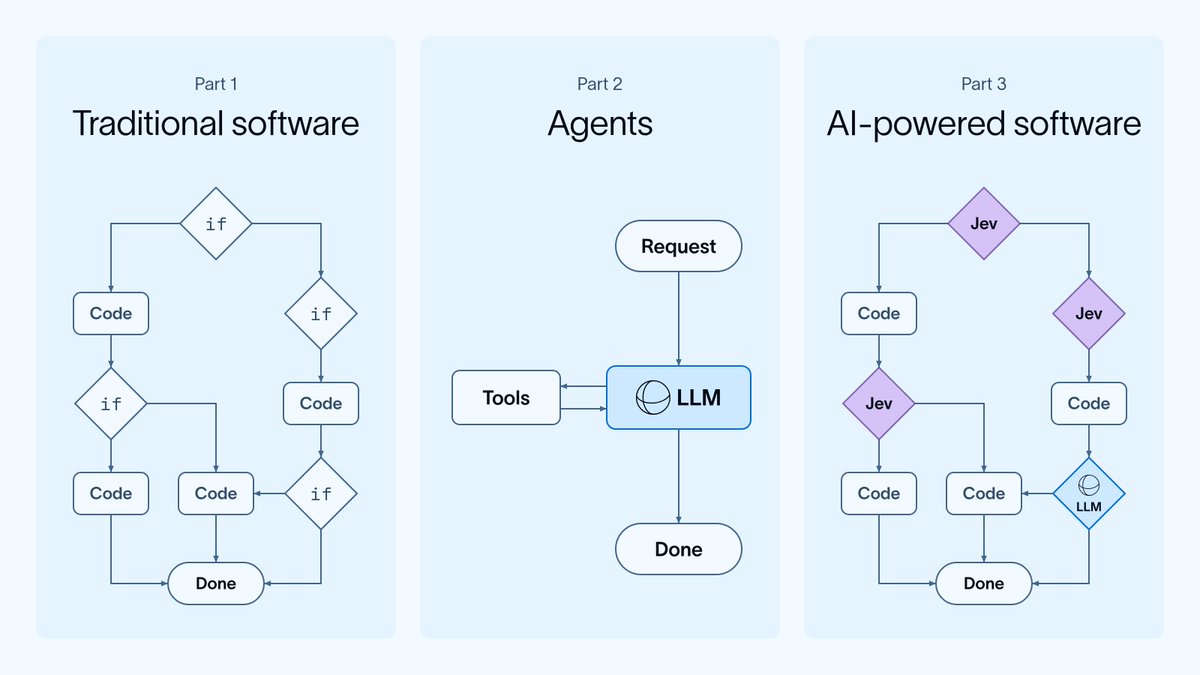
TypeSafe 的文档列出了三种构建软件的方式。传统软件由显式逻辑构成,每个分支都由人手写、可审计,但也因此僵化。Agent 则摆向了另一个极端:一个模型在每一步包揽各种决策,控制流从代码移进了 prompt。AI 驱动的软件走的是中间路线:代码保留结构、负责精确计算,模型只出现在需要语义判断的分支上。
Jev 之所以够格成为生产系统的组件,靠的是下面几个特性:
- 结构化:答案以带概率的类型化答案的形式返回,代码可以按可预测的方式根据结果进行分支
- 可并行:可以同时针对同一状态提出许多问题
- 快速:决策足够便宜,单次运行中可以做很多次
- 自洽:system one 的设计目标就是在重复评估中返回稳定的答案。
“💡 Jev 的一致性,相对 LLM 的非确定性是一种可喜的改变。同一个问题多问几次 LLM,你可能得到不同的答案;而 Jev 的设计保证相同输入返回相同答案。在一项早期的 Jev-as-a-judge 实验中,100 次重复运行的评分几乎没有波动,远小于我们测试过的任何 LLM 评审。”
举个例子,下面这段视频能帮你直观感受 Jev 与 LLM 的工作方式有何不同。这里的任务是判断输入中是否包含各种类型的 PII:
真实的应用要做出大量决策,而每个决策又错综复杂地依赖于之前的选择。当决策变得如此便宜,挑战就变成了如何编排它们——这正是 LangGraph 的用武之地。
用 LangGraph 做编排
多年来,我们一直在帮助团队围绕 LLM 构建系统,几乎每个团队都会遇到同样两个问题:
- 上下文管理很难。模型要做出正确的决策,它的上下文窗口里需要“恰好是下一步所需的信息”。这些信息是模糊的,而且会随应用的运行而不断变化。
- 模型驱动的系统仍然要可靠。它们必须能在故障后恢复、支持人工介入,并让每一步都可观测。
现有的框架解决了其中一部分问题,但没有一个能在不限制构建方式的前提下把两者都解决。于是我们构建了 LangGraph。如今它的月下载量超过 6000 万次,许多正在用 AI 做事的《财富》50 强企业都在使用。
状态即上下文
一个 LangGraph 应用由三部分组成。节点(Node)是工作单元:可以是普通代码、一次模型调用、一次工具调用,或整个子图。状态(State)是节点读取和更新的信息。边(Edge)决定下一个运行哪个节点,要么沿固定路径,要么根据当前状态动态决定。
任何图本身也可以是更大图中的一个节点,因此经过测试的小组件可以组合成更大的系统。TypeSafe 的宣言对智能下了同样的赌注:小而清晰的原语,正是让复杂系统保持可信的关键。
图运行时,每一步的结果都会累积到状态中。这些状态随后成为后续每一步的上下文,同时也决定了接下来运行哪些节点。
你不再把领域知识塞进 prompt,而是把它编码进图的拓扑结构:要做哪些决策、按什么顺序做、每一步能看到什么状态。用 TypeSafe 的话说,软件因此能够“基于意图和常识进行分支”。判断力来自模型,但流程仍保留在你可以检查和测试的代码中。
可靠的运行时
正如 TypeSafe 宣言所论述的:只有当组件足够可靠,你才敢让它无人值守地运行;只有当你能检查、测试并约束它,你才会在它之上构建。LangGraph 在运行时层面做到了这一点:
- 持久化执行(durable execution):模型驱动的步骤是非确定性的,同样的输入可能让模型走向不同的调用,使整个运行走上不同的路径。失败后从零重跑不只是慢——重跑未必会重复同一条路径。检查点机制会在每一步持久化状态,因此失败的运行可以带着已做出的决策从中断处继续
- 人工介入(human in the loop):当某个步骤在系统采取行动前需要审核时,interrupt(中断)机制让你可以暂停、批准,然后从上次中断的地方继续
- 可观测性:模型驱动的步骤不会每次都做同样的事,所以你需要 LangSmith 中的 trace 来看清做出了什么决策、为什么
这些保障并非 LLM 专属。Jev 接收的仍是非结构化的文本上下文,返回的仍是一个判断,因此它同样需要这些保证,而图会自动把它们赋予每个节点。

示例:证据开示中的文档审阅
在诉讼中,公司必须逐页审阅之后,才能向对方提交(交出)文件,而单个案件的材料可能多达数十万页。这些审阅大部分是同一种有边界的判断被一遍又一遍地重复,这正是 Jev 的天然适用场景。
对每一页,Jev 在一次请求中回答三个问题,每个答案都映射到图中的一条 route:
- 这一页是否与调取请求相关?若不相关,就搁置一旁。
- 它是否包含个人信息?若是,就由 LLM 对其中的 PII 做脱敏处理。
- 它是否可能涉及法律特权?若是,就进入 attorney_review,让图暂停下来,等待人工介入。
剩下没有问题的页面就可以交付了。下面是这个流程的快速演示(实际运行中,各页是并行处理的):
所有分类都由 Jev 处理,只有当某一页需要更多处理时,图才会升级:交给 LLM 做脱敏,或交给律师做特权判定。
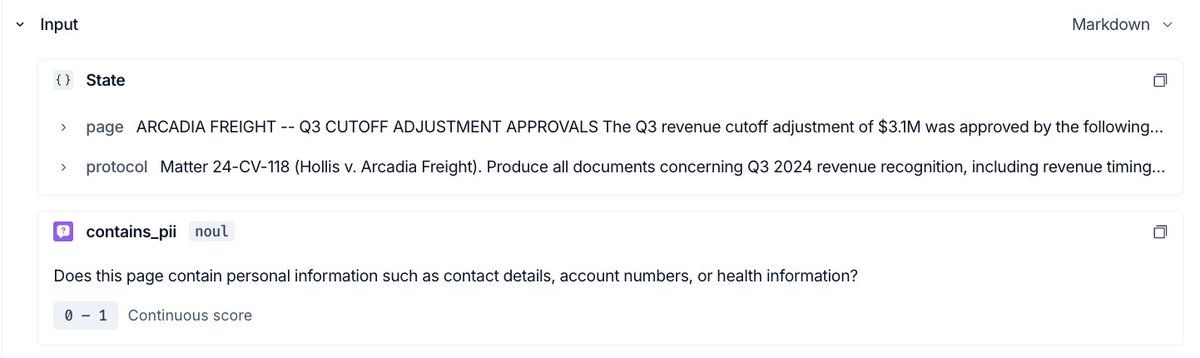
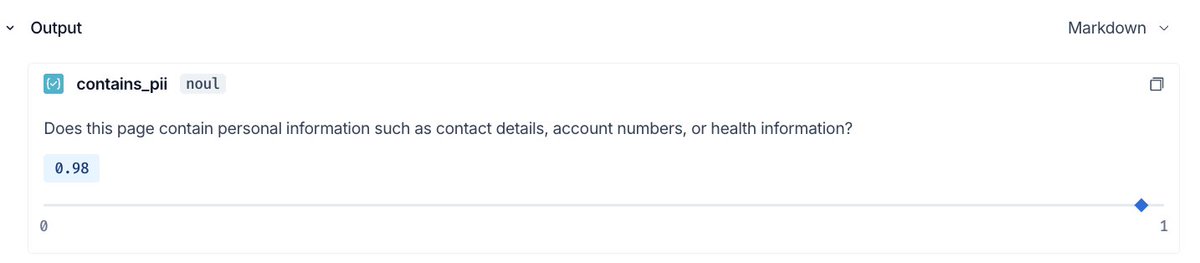
我们用同一张图分别测试了由 Jev 负责分类和由 Sonnet 充当评审两种方案,在多轮试验中,Jev 在分类这一步快了 5–6 倍。两次运行都在 LangSmith 中留有 trace,你可以打开任意一页,查看它走了哪条 route,以及背后的概率。LangSmith 还为 Jev 这类决策模型提供了专门视图,展示每个决策的输入和经过校准的输出:
智能的大拆解
过去三年,大多数 agent 都把所有事情交给同一个前沿 LLM 来处理。Jaya Gupta 把接下来会发生的事称为“智能的大拆解”(the Great Unbundling of Intelligence):这些能力将被拆开,每一项都交给能胜任它的最便宜的模型。Jev 拆出的正是判断力——它返回结构化的决策,而不是生成的文本。而一旦各部分被拆开,就需要有东西把它们重新缝合起来:为每一步做 routing,并决定何时升级。这就是运行时的职责。
浏览器自动化展示了这在实践中是什么样子。浏览器 agent 读取页面并决定下一步做什么:点按钮、填字段、滚动。这听起来很开放,但在任一时刻,页面上可交互的元素是有限的,所以下一个动作其实就是从一份列表中做选择。
Browserbase 围绕这一思路重构了 Stagehand 的 act()。Stagehand 标记页面上的可交互元素,Jev 选出动作类型和最佳候选元素,凡低于 0.7 置信度阈值的情况则回退到 LLM。在早期测试中,act() 的中位延迟从 1.97 秒降到 0.46 秒,快了约 4.3 倍。
对大多数用例来说,Jev 并不能完全取代 LLM。它处理自己有把握的有边界选择,把其余一切都交给 LLM。这正是 Gupta 所描述的转变:从“默认前沿、之后再优化”转向“默认廉价、例外才前沿”。我们预计会看到更多这种模式:凡动作空间受限之处,都由决策模型快速、廉价地做出判断,LLM 则留作开放式推理之用,以及处理小模型拿不准的情形。
开发者们已经在朝这个方向走。本周有位开发者告诉我们:“我基本上正在把我们现有的每一个 agent 都改造成由 Jev 驱动的工作流。”
上手指南
- 想了解 LangGraph 运行时的工作原理,请阅读《3 years of graph engineering with LangGraph》
- 想了解 Jev 如何融入 agent harness——包括 model routing 和 auto mode 分类器——请阅读《Building a harness with Jev》
- 用 LangSmith 监控和评估你的 agent
致谢
本文由 Sydney Runkle 和 Hunter Lovell 撰写。
感谢 Kevin Frank、Harrison Chase、Eugene Yurtsev 和 Nathan Drezner 的审阅与建议。