
持续消费,改变了市场的形状
查看原文 02:47Alex Atallah 用发布与订阅数据理解产品。在市场里,供应方发布供给,买方作选择;代理和消费推理的应用,却可能持续选择,而不是偶尔进行一次人工购买。
他把 OpenRouter 看成 API 与市场的结合:开发者需要可调用接口,也需要发现、比较模型供给的方法。他对早期开放模型的回顾,解释了为什么预期会出现多样能力,而不是一个永久选择。
访谈里的早期微调故事,不是建设生产服务的完整成本模型。更普遍的论点是,新模型变体除了带来训练问题,也带来发现和分发问题。
社区审核,暴露了控制需求
查看原文 10:31Anjney Midha 回顾在 Discord 部署模型的经历,各社区有不同规范。通用审核端点,与让模型解释某个社区的具体规则,并不是同一种应用。
按照他的叙述,早期后训练限制有时妨碍预期的审核任务,因此更重视对模型与部署的控制。Atallah 另举创作任务无法完成时,用户希望切换选择的例子。
这些是特定部署的历史叙述,不证明某个提供方今天仍以同样方式工作。它们解释选择与控制的需求,却不证明不受限制的模型访问能消除全部审核和安全责任。
模型多样性是前提,不是附带功能
查看原文 16:52嘉宾回顾早期质疑:如果一家模型公司拿走几乎全部价值,市场就没多少事可做。他们反而预期,不同团队、能力和部署选择会持续存在。
论点结合研究多样性与应用实际需要。速度、价格、定制和可接受行为,在不同任务里的重要程度不同。开发者有理由不选某个综合基准领先的模型。
这是关于生态的判断,不保证未来市场结构。访谈没有证明任何提供方都不可能获得很大权力,也没有证明每个应用都必须使用多个模型。
完成检查点,不等于完成开发者产品
查看原文 19:47Midha 描述一个反复出现的缺口:研究团队产出检查点,离开发者真正使用仍有距离。密钥、资源开通、端点、版本管理、分发和反馈,都需要训练之后的工作。
Atallah 又增加发现问题:模型很难用一张简单功能清单解释。人们需要例子,也需要理解哪些能力适合自己的应用。他把市场定位为帮助显露差异的中立层。
中立是公司的自我定位,不是关于全部激励和比较都无偏的独立结论。更具体的观察是,只转发一次请求的代理,不能解释完整开发者体验。
社区工作,能显露缺失的体验
查看原文 29:50嘉宾把市场建设与此前社区经验相连:找到人们真正在乎的技术缺口,围绕它建设,并从同一处的许多用户学习,而不只依靠孤立访谈。
他们回忆,某次 Discord 集成满足技术要求,却把用户弹到另一个网站。Atallah 提议把交互嵌入当前环境,Midha 用它说明,能工作的集成是否也是最好的用户体验。
这是回忆,不是受控产品实验。它在访谈里的作用是说明,两个公司或系统的边界,不应自动决定用户必须经历的边界。
Window AI 帮助识别了浏览器形态的限制
查看原文 35:37Atallah 描述过一个早期浏览器扩展,让用户选择页面调用的模型。开源贡献也通过这个实验,把他与后来的联合创始人联系起来。
他的结论是,产品需要 API,以及更大的发现空间:例子、图表和探索,不是一个小扩展所能提供。有用原型可以让团队离开最初界面,而不一定直接长成最终产品。
与 Midjourney 的比较让区别更清楚。看别人做图,可以成为终端体验的一部分;用语言模型建设应用,还需要代码集成、访问治理与数据政策。共享聊天社区,不足以完成这份工作。
更快可能显得更聪明,却不证明更准确
查看原文 45:33Mixtral 讨论把模型需求与推理提供方竞争联系起来。嘉宾回忆,开发者想试开放模型,提供方则竞争有吸引力的性能与价格。
他们也追问,速度是否影响了对智能的感受。Midha 明确说,准确性比较需要回到数据检查。因此,本文不把这种推测改写成基准结果。
实际区分在于延迟、任务质量与人类偏好。快答案可能有用,较难任务却可能值得另选模型。对话把人工切换模型,呈现为自动路由的前身之一。
评估研究者与应用开发者,是不同客户
查看原文 49:08被问到 OpenRouter 为什么没有变成 Arena 时,嘉宾区分了目标客户。评估服务面向测量模型的研究者,部署市场则面向用模型建设应用的开发者。
Atallah 也描述了保守处理提示词和回答的方式,受到提供方政策与主动开启设置影响。这些是他在访谈中的表态,不是本文核实过的当前隐私合同。应用仍需检查实际路由和配置适用的政策。
产品教训是聚焦。相邻工具远看相似,却可能服务不同期待、数据关系与业务模型。试图包办所有附近流程,可能削弱最初要服务的那一种。
被放弃的原型,说明相邻想法的成本
查看原文 57:09Atallah 回顾了一个以视频为输入的微调原型,它没有成为主要产品。团队也试过,把多个模型的回答交给一个更强模型综合。
早期融合实验的结果,可能不优于,甚至差于直接使用最强模型。更多模型不自动意味着更有用。团队删除了原型,而不是无限分散注意力。
当模型变得更接近时,他重新探索融合。个人抽查和模型给出的正面评价推动进一步评估,却不是效果更好的独立证明。访谈保留了模型质量、产品形态与认真测试这些条件,它们会改变想法能否成立。
能力、使用量与成本压力可能互相推动
查看原文 64:41嘉宾描述一种循环:模型能力带来新应用,使用增长,账单开始显眼,开发者再寻找更高效替代。市场在发现与成本管理两个阶段都可能有用。
新的代理形式也产生不同调用。简单心跳,不必与困难编码任务拥有相同成本和能力要求。因此,路由关乎任务,而不只是对某个模型的偏好。
Token 数、账号数与美元活动是不同指标。访谈包含很大的口述使用量,却不能被解读为独立活跃客户、经审计收入,或每次调用创造的经济价值。
失控调用,不等于攻击
查看原文 71:01Atallah 的滥用例子包括盗用支付方式、账号失陷与未经允许的转售。他另外描述,代理意外持续消耗,而操作者没有意识到的情况。
这些情况需要不同应对。检测恶意访问与帮助合法客户重新获得控制,都与信任相关,却不等同于诊断失控工作流。他描述的是信任与安全团队的运营工作,不只是模型层拒绝规则。
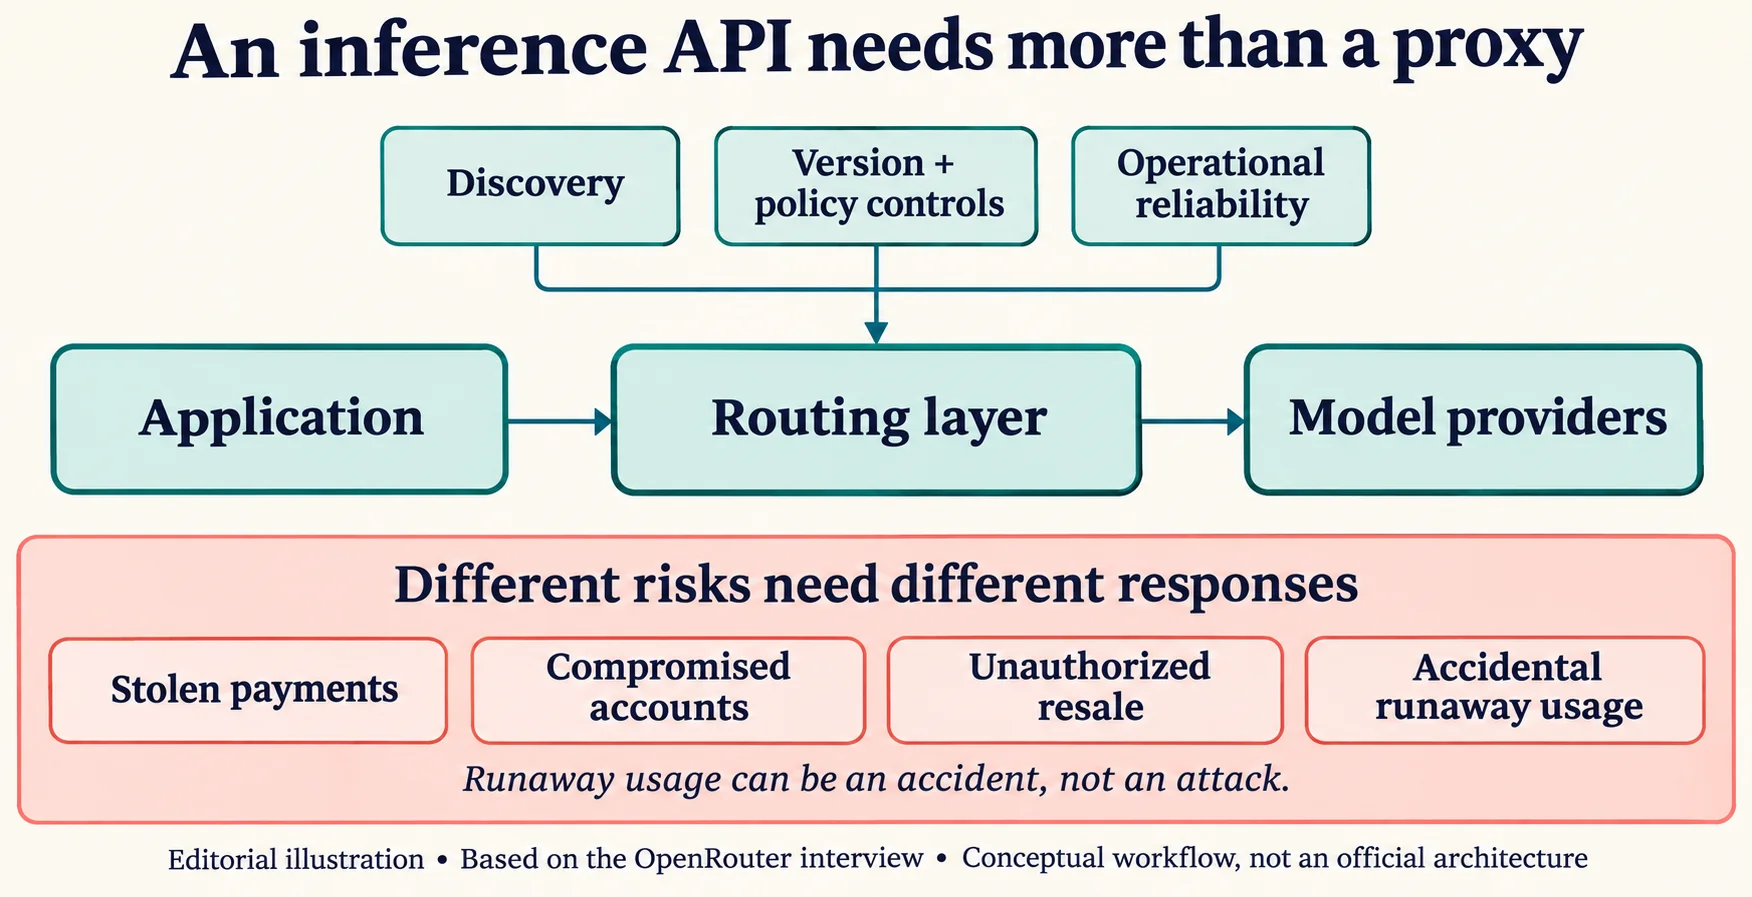
他也设想,企业可能按任务或事件收费,让用户另外带入推理。这是可能的定价方向,不证明任务型产品免疫欺诈,也不证明转售推理无法成立。
万亿美元经济,是关于未来基础设施的论证
查看原文 74:42Midha 把 Token 流动与在线支付增长相比,并回忆早期图像生成试用被滥用。类比的意思是,有价值的服务规模化后,会吸引非法获取,从而需要新的保护。
五万亿与十万亿美元,是面向未来多年的预测,不是已经测得的当前市场规模,不是 Token 数换算,也不是经过验证的 GDP 增长估计。他对代理攻击的担忧,同样是前瞻风险,不是观察到的未来损失总额。
即使不接受预测,设计问题仍成立:应用开放有经济价值的推理时,怎样检测滥用、控制错误,并让合法客户仍然获得可用体验?
合作计划,不替代运营保证
查看原文 80:56访谈结尾,嘉宾把 Stripe 关系放在分发与信任安全能力的背景里解释。Atallah 说,OpenRouter 品牌和产品方向会继续,希望近期工作推进更快。
这些是录制对话里的表态与计划,不是独立确认交易的新报道,也不保证今天的路线图。本文不把它们变成服务级别或隐私承诺。
整个经历反复出现同一主题:有用的智能访问,包含调用周围的工作。发现、清楚的客户定位、治理、成本选择与运营信任,都是产品的一部分,每一项都需要超出巨大 Token 总量的证据。