
标题背后是一套系统,不是手动聊了 2500 次
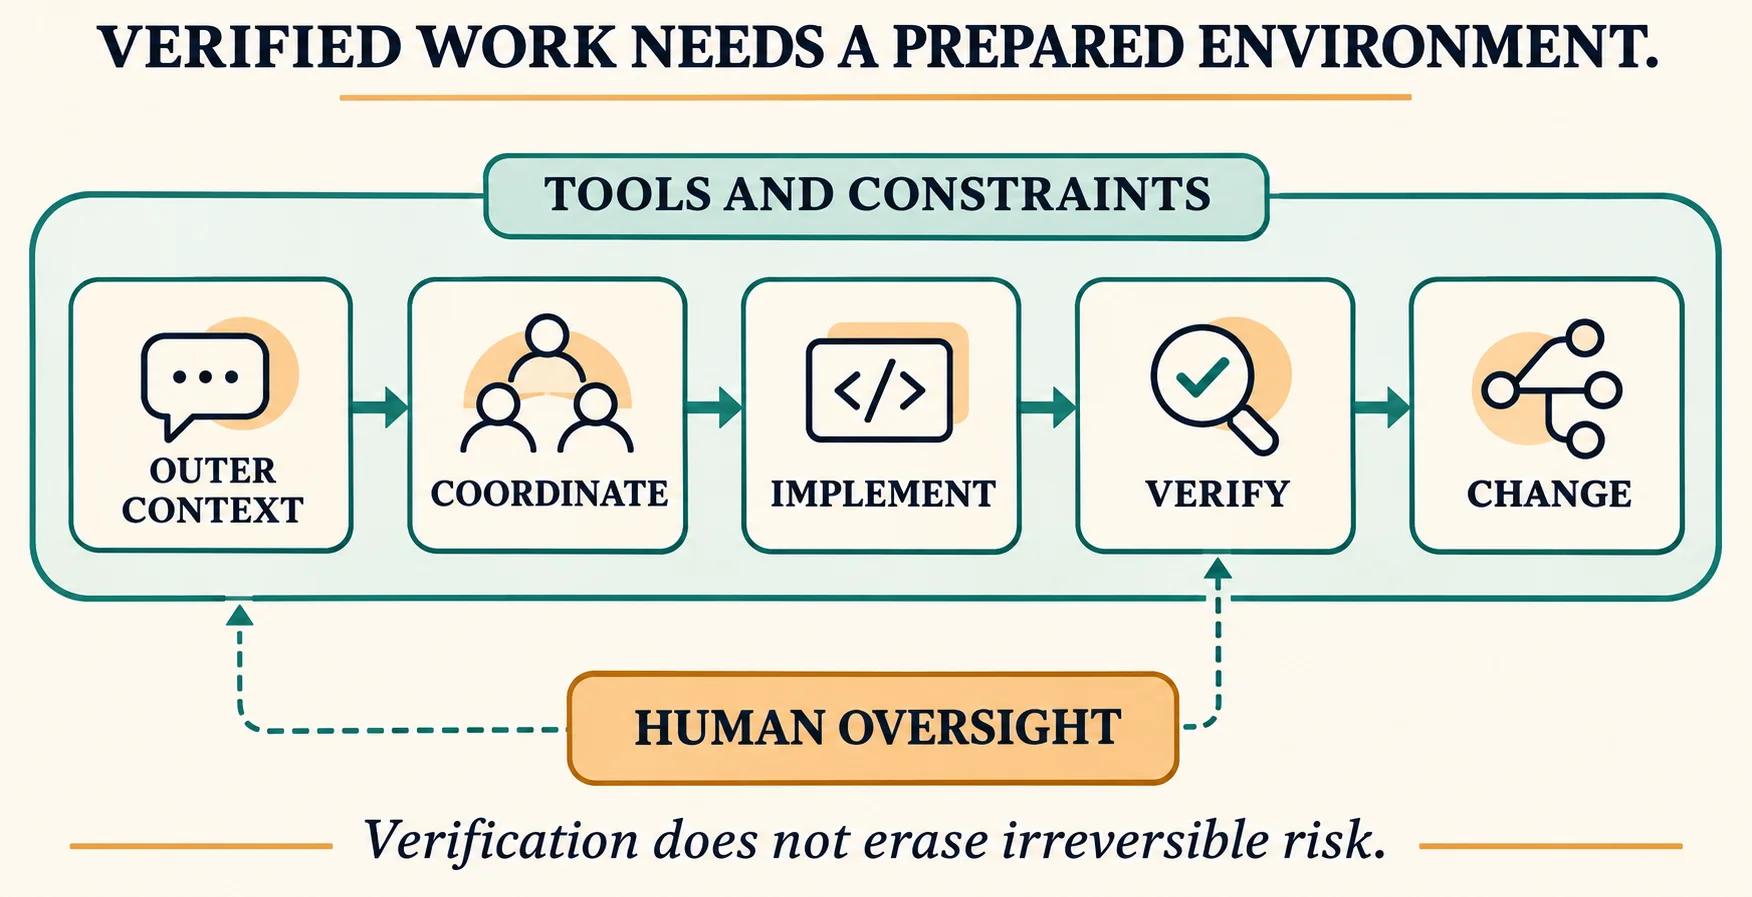
查看原文 32:59网名 Poteto 的 Lauren Tan 用相互连接的工作流解释较高的月度代码变更数量,而不是数千次手动开启的聊天。外部信号带来工作,协调者整理相关任务,智能体在准备好的环境里执行。
她明确说,这不等于 2500 个功能。相当一部分是“园艺式维护”:改善结构、消除重复问题,让所有人的工作环境更好。这个数字是她在访谈中的陈述,不是对生产影响的独立审计,也不是其他团队应该照搬的目标。
厨房比喻让工艺与责任继续可见
查看原文 11:10Tan 更喜欢米其林厨房的比喻,因为产量增加不应意味着放弃工艺。独自做饭的人包办每一步,协调他人的主厨则要安排工具、食材、准备过程和时间。
这个比喻强调,在增加执行者之前先设计环境。更多人挤进没有准备的厨房,可能只会制造混乱;更多智能体也可能放大薄弱的配置。人仍然与最终结果联系在一起。委派实现改变的是承担责任的工作方式,而不是让责任消失。
专业知识帮助把意图变成可执行过程
查看原文 06:22嘉宾把领域专业知识与表达目标、识别糟糕产出的能力联系起来。如果含义确实适合任务,“测试驱动开发”或“同义反复式测试”之类的词,可以把丰富预期压缩成简短指令。
但关键词不构成正确性保证。Tan 最初的问题,是花太多时间微观管理和纠正一个智能体。更有用的问题逐渐变成:自己的哪一部分经验,可以变成可重复流程、工具或约束,让同样的纠正不必再次发生?
验证让智能体接触实际结果
查看原文 16:14性能工作暴露了人在智能体与浏览器工具之间充当代理的局限。Tan 希望智能体自己运行应用、与之交互、收集追踪或快照,而不是每次都等她转述观察。
这种反馈才能形成循环:尝试改动,观察结果,按标准比较,再决定下一步。它可以支持围绕可测目标的迭代爬坡,但目标与观察本身仍要有意义。智能体说自己验证过,不等于应用确实运行过、结果也确实经过检查。
把确定性工作放进工具,让判断用在需要的地方
查看原文 19:24Tan 描述了围绕浏览器与调试接口构建的小型 CLI。重点不是技术多新,而是避免每个智能体都重新写一套略有不同的验证脚本,用完又丢掉。
可复用工具让机械步骤更一致、更快,技能则解释工作流及何时使用。类似区分也适用于迁移:机械的语法转换可以放进 codemod,但判断转换后的程序是否保留行为,仍需要证据和判断。
重复失败,应当推动环境变化
查看原文 25:10讨论把约定式功能目录、lint 规则、类型约束和运行时检查,视为收窄实现路径的方法。Tan 举出的内部框架,希望让新增功能该放在哪里一目了然,并避免不断向庞大的总文件追加代码。
比框架名称更重要的是反馈过程:观察反复出现的变通或错误,再判断能否用规则、抽象或工具防止这一类失败。不是每个偶发问题都需要新增规则,也没有有限约束能让所有坏代码都不可能出现。目标是减少无谓选择与重复错误。
把外部背景循环与内部实现循环接起来
查看原文 35:08Tan 把围绕某个意图推进实现称作内部循环。错误报告、变化中的需求和运营背景,则从团队消息、工单等外部系统进入。如果两者不连接,就需要人不断搬运更新,原来的意图快照也容易过期。
她描述的做法,是把这些信号接给协调者,归拢相关工作,再分派有边界的任务。智能体应该取回真实证据、复现报告的问题、判断问题是否仍存在,而不是猜测。每来一份报告就单独启动执行,可能错过共同原因并重复劳动,因此需要保留更大的线索。
先缓冲归拢,有时比立即执行更有用
查看原文 45:51访谈中的一个例行流程会扫描不良代码模式,却先把发现追加到文档,而不是立刻逐个修复。每隔几天查看这份缓冲记录,可能发现许多条目其实是同一问题的不同表现。
这是对“有信号就立即制造更多执行”的有意替代。保留下来的材料,为人或协调者识别模式、选择更完整修复、改善环境留出空间。有意义的规模是有效归拢的工作,而不是同时运行的智能体数量上限。
抽查与验证,仍需要持续的人类关注
查看原文 49:10Tan 没有说自己在合入前读过每一份变更。她描述的是严格抽查、多轮验证、浏览器交互,以及之后检查提交历史,必要时纠正或回退。她也承认,这套配置需要大量 token,以及前期持续建设的时间。
关键限定是,这种信任来自特定环境和反复观察。安装技能库,不会把这些证据自动转移到另一份代码库。合入后检查是她报告的运营选择,不是对所有变更都取消阻断式审查的普遍建议。
可验证,不等于不可逆后果已经可逆
查看原文 55:44主持人提出数据丢失等“单向门”,以及难以验证的领域。Tan 承认,可验证性构成限制,自己也没有完整答案。关于证明的讨论表达了一个研究兴趣方向,并没有展示对所有生产风险的解决方案。
测试通过、编译成功或证明成立,检查的都是特定假设下的某些性质。它们不会物理上恢复已经丢失的数据,也不能确立全部需求、权限和现实后果都正确。因此,信任阶梯需要边界:范围与证据必须匹配后果,尤其在改动并不容易撤销时。
从纠正记录提炼自己的流程,而不是寻找神奇框架
查看原文 59:42结尾的建议,是回看过去工作中人反复介入的时刻。这些纠正可能暴露缺失的规则、值得复用的工具,或者应该写成技能的工作流。
嘉宾把技能库视为用语言写下、可以修改的流程。组合它们应当服务于已经理解的工作方式,而不是品牌忠诚,或“指令越多越好”的假设。持续的做法是理解并打磨自己的工具,再继续检查它们是否产生了预期结果。