
先问:究竟是谁在改进什么
查看原文 02:28嘉宾首先区分了两件事:人类研究者使用 AI 工具,以及系统把改进重新投入自身的改进能力。按他们的定义,用 AI 写出更快的内核本身还不够,重要的是被改进的部分是否反馈到优化者自身。
这是他们把递归自我改进与更广泛的技术自催化区分开来的方式。技术帮助人制造更好的技术,并非新现象。由于 RSI 一词含义混杂,这种区分应视为评估主张的一个视角,而不是已经统一的普遍定义。
图上闭合的箭头,不等于已经发生起飞
查看原文 04:41对话用一个简化的改进速率模型解释问题:能力增强可能让下一轮改进更容易,难度和资源成本则可能向相反方向作用。不同关系会产生很不一样的轨迹。
主持人质疑,从反馈循环直接跳到必然指数起飞的推论。嘉宾同意,关键量需要测量,不能从画出来的循环中预设。非线性系统可能停滞、振荡,也可能在不同维度不均匀改善。访谈没有提供一个拟合模型,让读者可以据此推导真实起飞日期或增长定律。
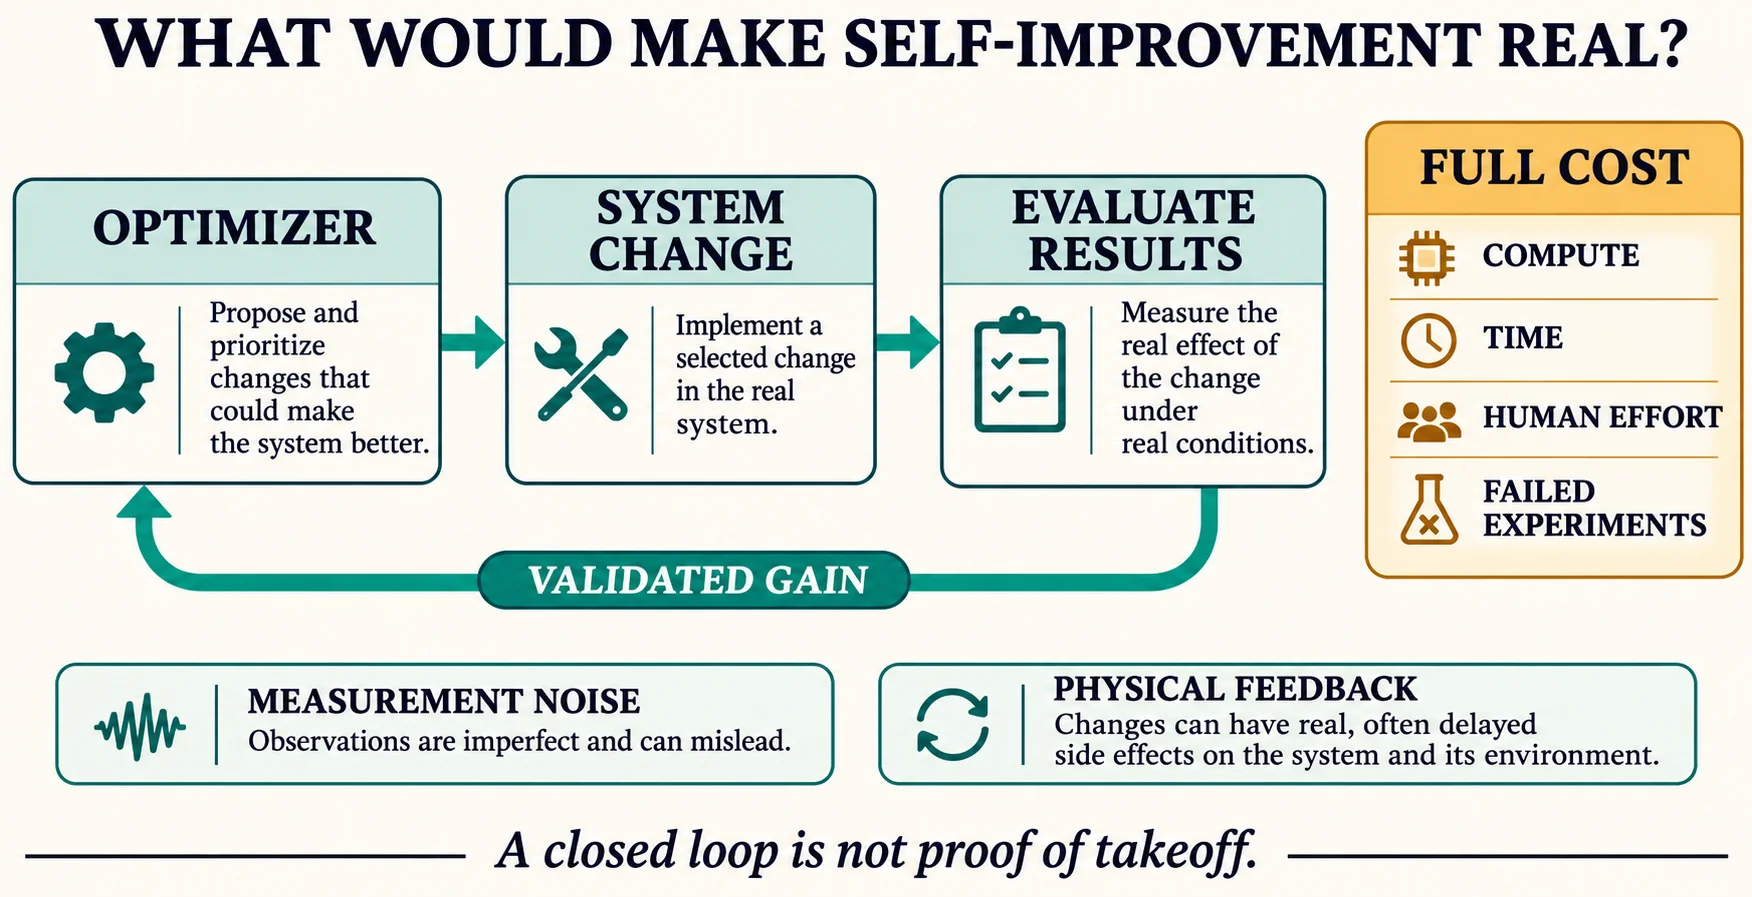
分母里也要算上没有成功的实验
查看原文 09:27发布周期变短,可能来自更多资金、算力或人手,而不是自我改进过程更高效。因此,主持人要求把人工投入和失败实验一起计入成本,不能只看最后一次成功运行。
嘉宾描述了内部对时间和成本的跟踪。同硬件训练的例子,用来说明算法效率与购买更多硬件的区别,但本文没有独立核实其中具体费用。降低某个组件的成本,与提高前沿能力存在联系,却不是同一个测量。
优化相互作用的层,而不是孤立分数
查看原文 13:42嘉宾主张把提示、运行框架和权重放进统一视图,更远的目标则延伸到栈的其他层。框架变化会影响模型如何被使用,权重更新也可能改变框架应当怎样工作。
他们说,一些看起来吸引人的研究想法没有在内部测试中成立,但访谈并未公开足够方法和结果,让外界独立裁决这些陈述。更有用的一般问题是:局部改进是否帮助了完整系统,包括成本与其他组件,而不只是提高一个选定分数?
推理效率是可能形成反馈的领域,不是通用解法的证明
查看原文 17:42对话把推理作为重点,因为系统运行更便宜、更快,也可能使下一轮实验更便宜、更快。嘉宾描述多个模型参与,以及智能体选择改进哪些组件,甚至涉及自身指令。
这些是他们对系统与目标的陈述。对话没有给出公开基准,证明已经存在跨领域通用解法。改善服务组件的循环,可能很有经济价值,但这并不能确立无限能力增长,也不能证明同样方法可以迁移到每个问题。
在他们描述的系统中,人仍然在内
查看原文 08:44嘉宾明确反对一种预设:整个过程必须已经完全数字化、完全自动化。他们把研究者和工程师描述为混合多智能体系统的参与者,组织方式本身也可以被改善。
这关系到性能与成本的评估。不能因为软件执行了一些步骤,就把人的决策、实验设计和调试从账本中抹去。同时,在概念上把人纳入系统,也不等于证明每一种贡献都能自动化,或以相同速率加速。
方差与奖励投机,可能伪装成改进
查看原文 24:52访谈中最强的主张,是内部已经看到性能与效率同时改善的迹象。在这里,它们仍是有归属、尚未公开验证的陈述。嘉宾自己也强调,要把真实增益与噪声、挑选结果区分开非常困难。
他们描述了专门质疑结果的人、重复实验,以及检查嵌套智能体工作流深处奖励投机的过程,也讨论振荡和硬件相关差异。这提供了一个评估上的教训:有说服力的分数需要可信测量过程,而不只是看起来漂亮的上升曲线。
现实流程中最慢的部分,仍可能主导结果
查看原文 26:50对话最后区分了反馈很快的领域,以及必须等待物理实验的领域。数字推理变快,并不会消除湿实验或临床评估本身所需的时间。
类似阿姆达尔定律的直觉是:加速其中一部分,流程剩余部分仍然存在。关于某个不起眼工业工作流的玩笑,指向未知约束,不是一条已经发现的定律或经过核验的企业案例。仍待完成的工作,是对照完整成本与真实瓶颈测量有用改进,并把起飞主张与闭环示意图分开。